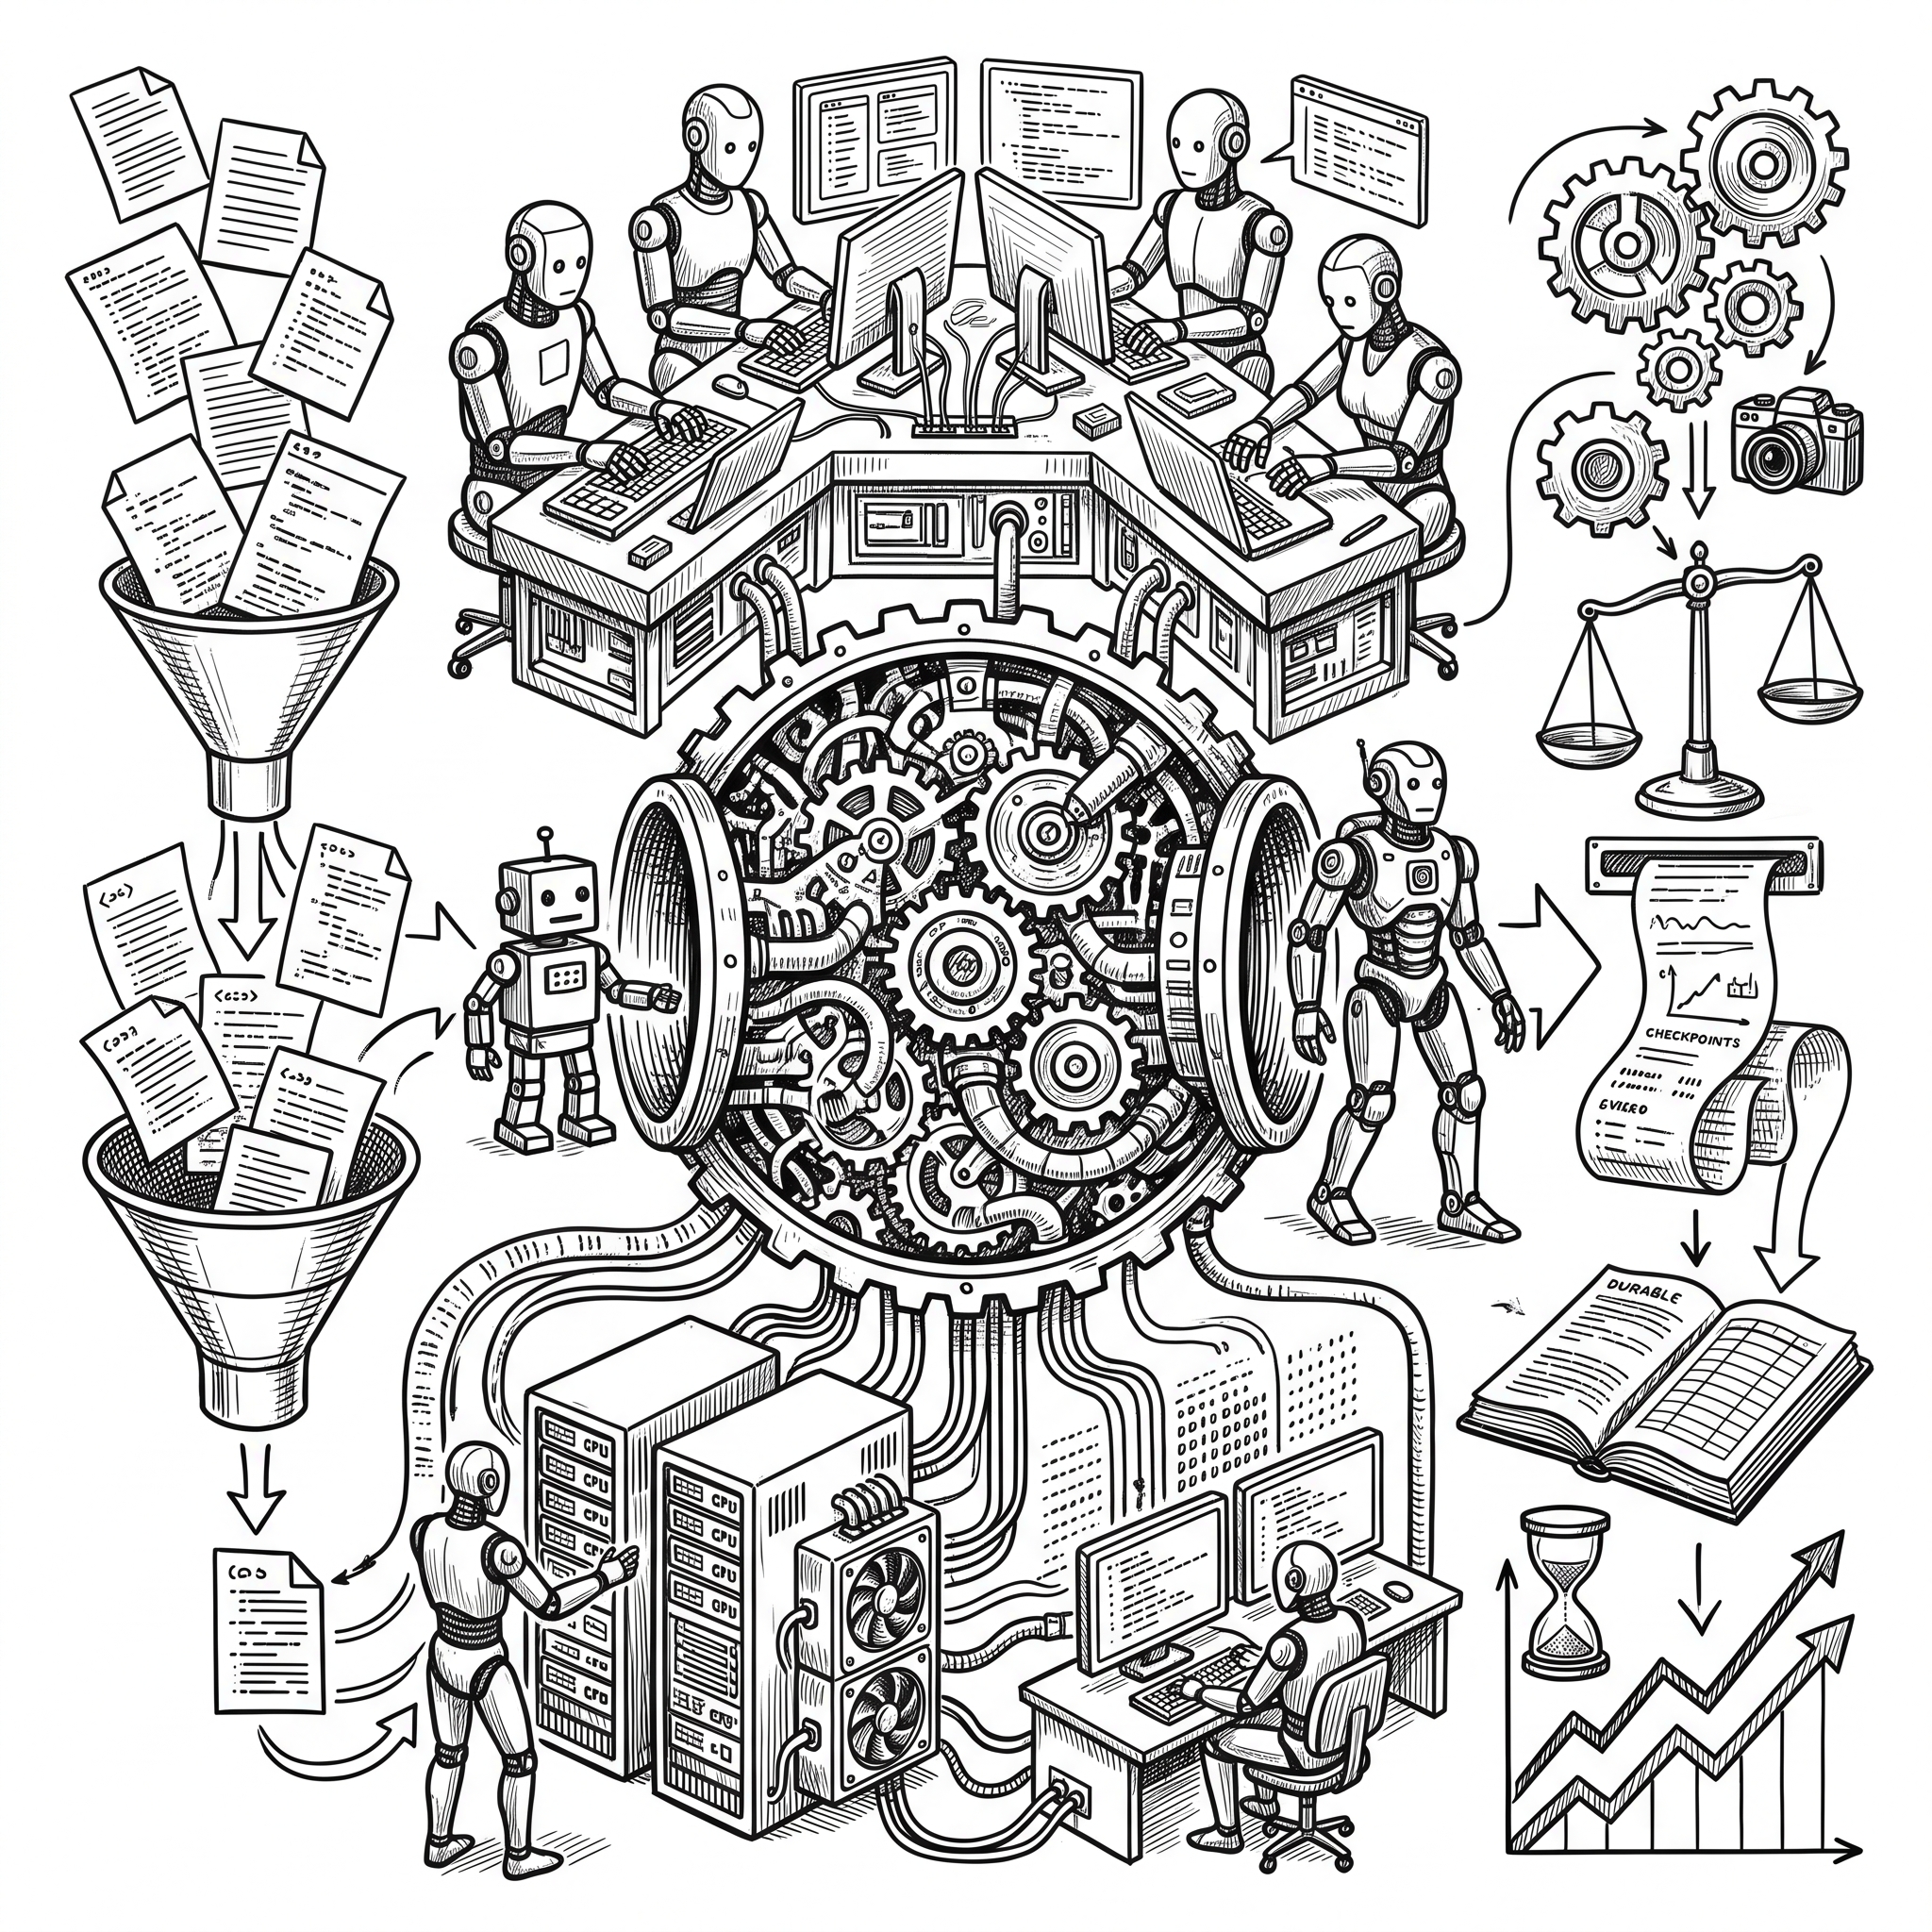
Un equipo de cuatro agentes de inteligencia artificial, cada uno operando un nodo con ocho GPUs, logró entrenar de forma autónoma el modelo base Qwen3-4B-Base hasta igualar el rendimiento de la versión instructa oficial de Qwen, según un artículo publicado por investigadores de ByteDance, Duke University, University of Chicago y Virginia Tech.
El sistema, denominado Athanor, permite a los agentes realizar investigación de post-entrenamiento sin intervención humana. Durante 104 horas, los agentes leyeron datasets, construyeron sus propios datos de entrenamiento, modificaron algoritmos, ajustaron hiperparámetros y analizaron resultados para decidir los siguientes pasos. No utilizaron modelos maestros externos ni recibieron asesoría de investigadores humanos.
Los resultados muestran que el modelo entrenado por los agentes alcanzó una puntuación de 67.3 en una suite de desarrollo de seis tareas, frente a 66.5 del modelo oficial Qwen3-4B-Instruct-2507. En una suite de validación oculta, el modelo de los agentes obtuvo 48.2 contra 47.9 del modelo oficial. El costo total de la campaña fue de aproximadamente 12,000 dólares, incluyendo tiempo de GPU y la inferencia de los agentes.
El análisis de la trayectoria revela que los agentes recombinaron métodos conocidos como ajuste fino supervisado, aprendizaje por refuerzo con GRPO, fusión de pesos y autodestilación. También compartieron ideas y checkpoints entre ellos, y en las últimas etapas todos los mejores modelos combinaban el trabajo de los cuatro agentes. Sin embargo, los investigadores observaron una convergencia temprana en una sola receta y una limitada diversidad de ideas, lo que sugiere que la exploración de alternativas es un área de mejora.
El equipo de investigación espera que Athanor sirva como base para escalar la investigación autónoma en inteligencia artificial.