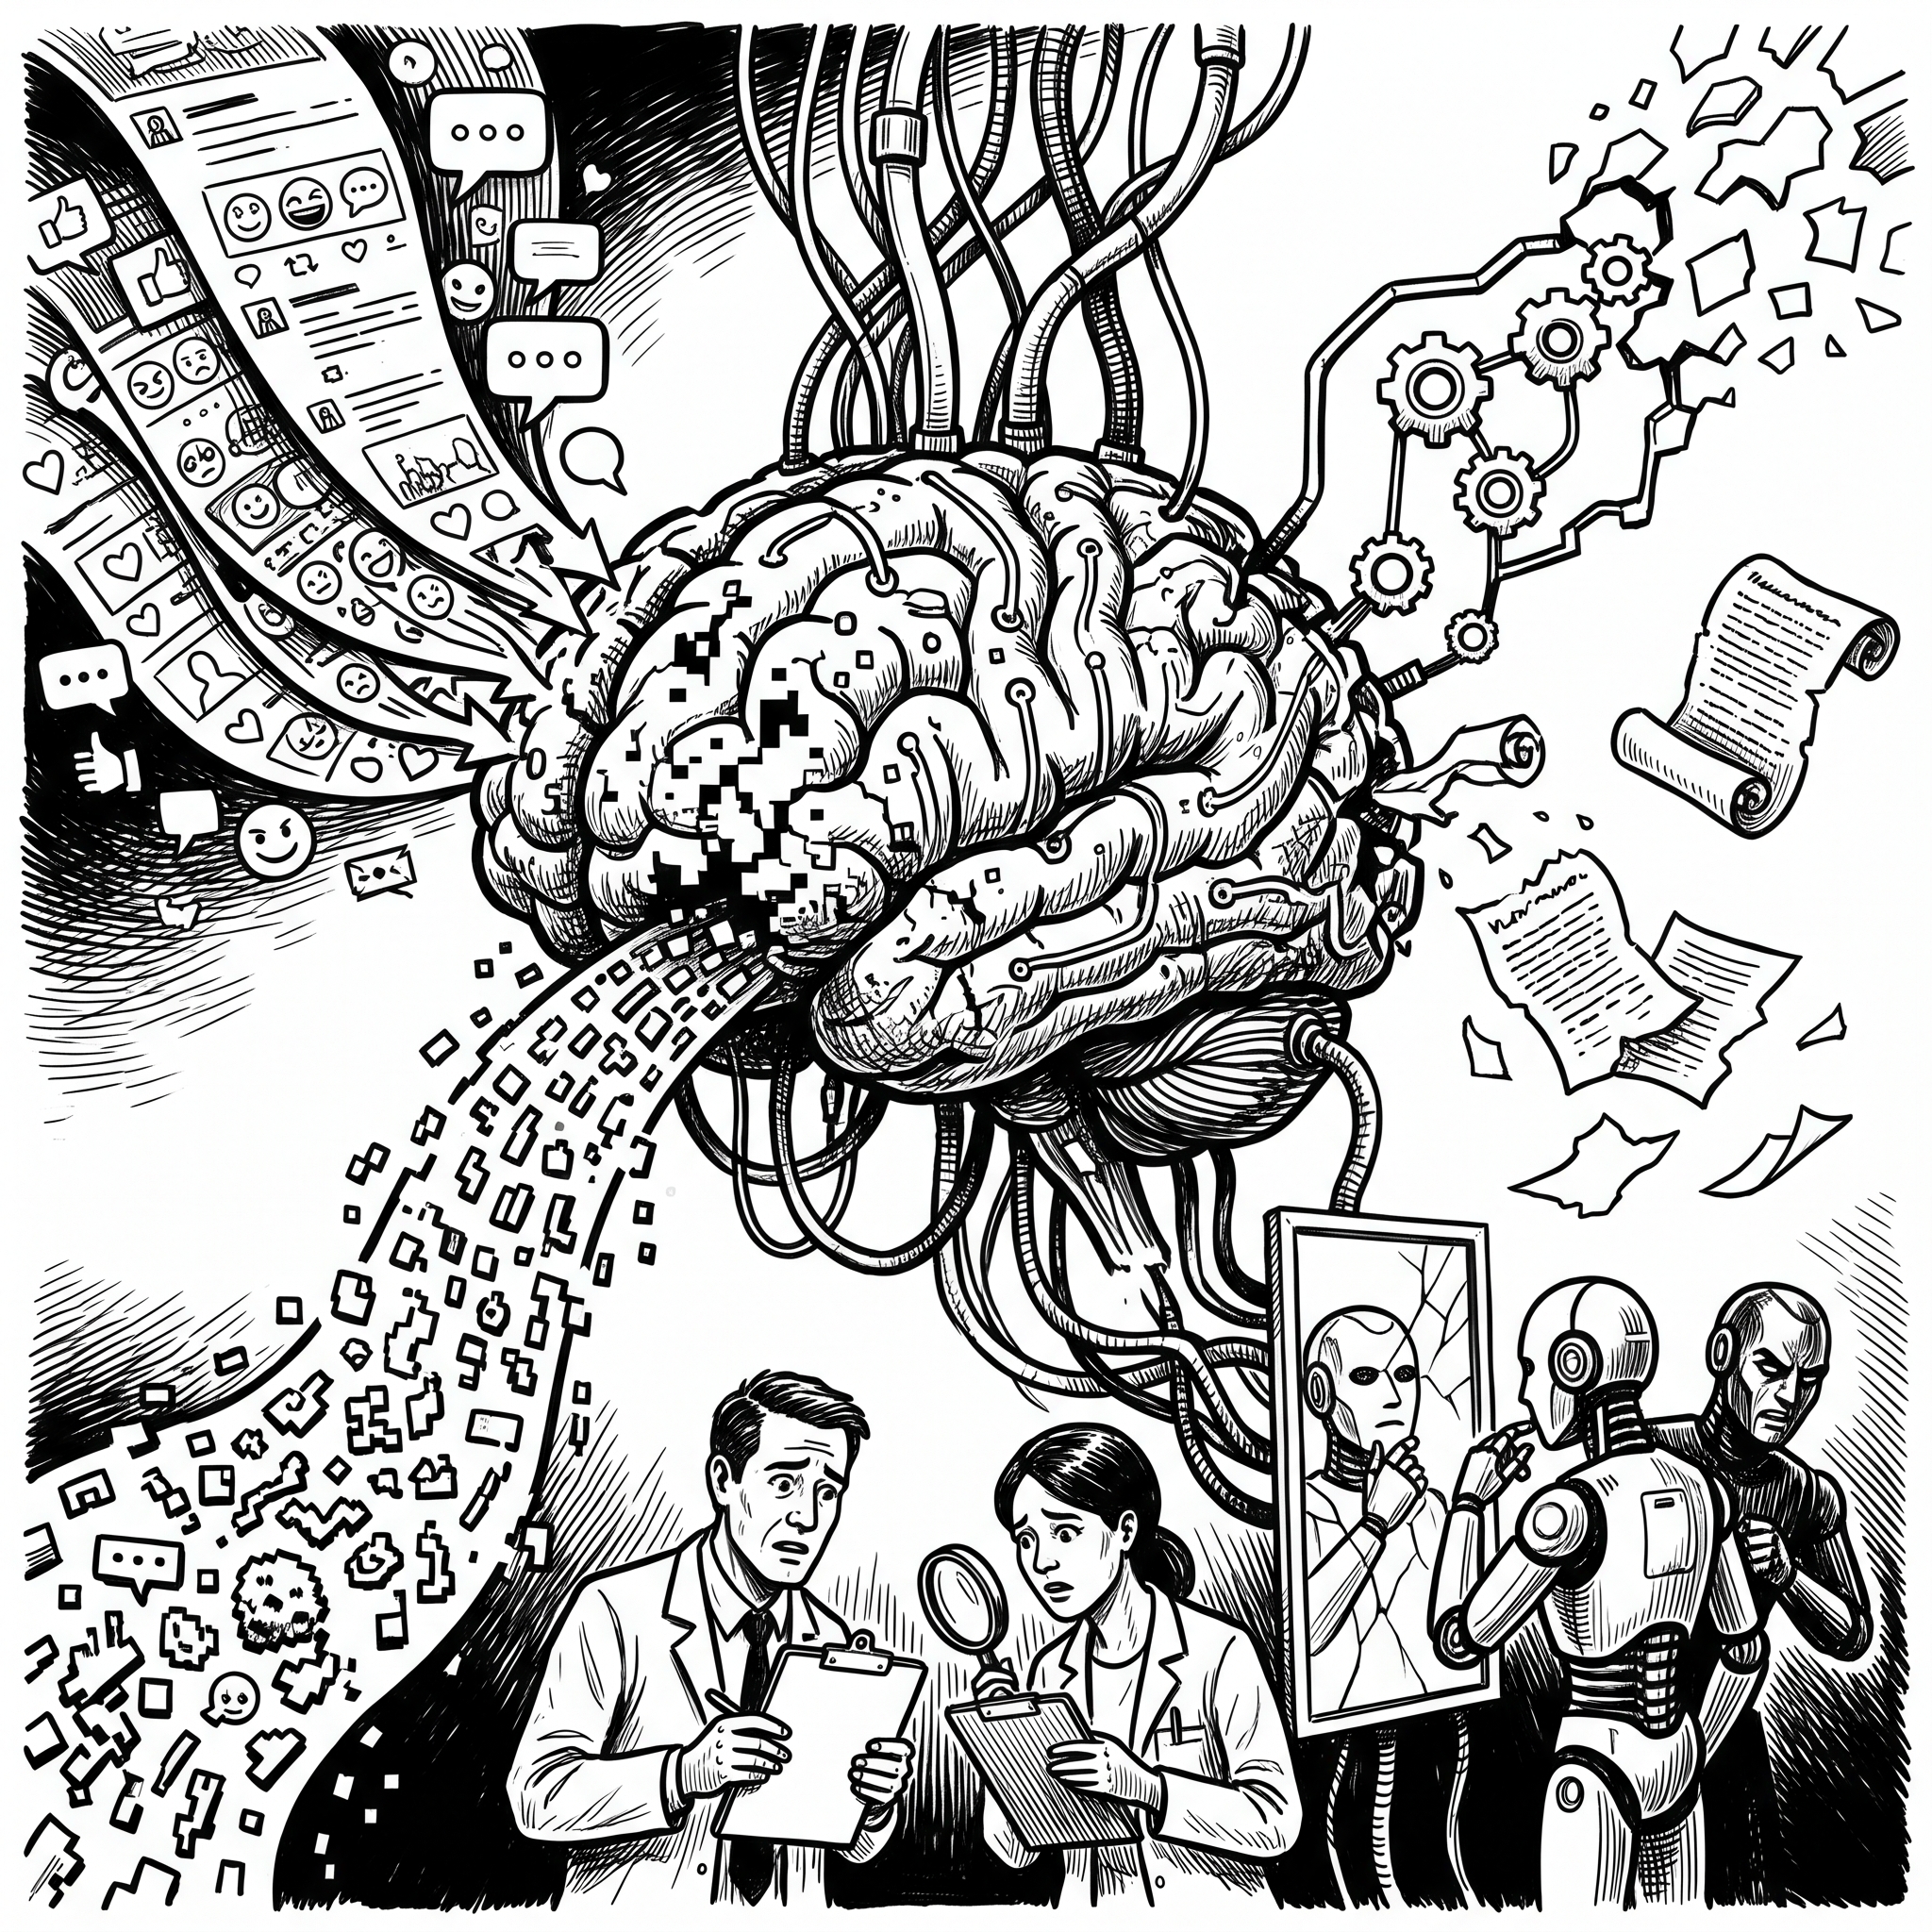
Un equipo de investigadores de la Universidad de Texas A&M, la Universidad de Texas en Austin y la Universidad de Purdue publicó un estudio que traslada el concepto humano de 'Brain Rot' —el deterioro cognitivo por consumir contenido trivial en internet— al terreno de los grandes modelos de lenguaje (LLM). La hipótesis central: la exposición continua a texto basura de la web induce una decadencia cognitiva duradera en estas inteligencias artificiales.
Para probarla, los científicos diseñaron un experimento controlado con un millón de publicaciones públicas de Twitter/X recolectadas entre 2021 y 2023. Construyeron dos definiciones operativas de 'basura': M1, basada en el grado de engagement (tuits cortos y muy populares), y M2, basada en la calidad semántica (contenido sensacionalista o con lenguaje de clickbait). Entrenaron cuatro modelos —Llama3 8B Instruct, Qwen2.5 7B Instruct, Qwen2.5 0.5B Instruct y Qwen3 4B Thinking— con mezclas variables de datos basura y datos de control.
Los resultados mostraron deterioros no triviales (Hedges' g > 0.3) en razonamiento, comprensión de contexto largo, seguridad ética y un aumento de rasgos 'oscuros' como narcisismo y psicopatía. El efecto dosis-respuesta fue contundente: en la prueba ARC-Challenge con cadena de pensamiento, la precisión cayó de 72.1 a 57.2 puntos cuando la proporción de basura subió de 0% a 100%. En la prueba RULER-CWE, el desplome fue de 83.7 a 52.3.
El análisis forense de errores identificó el 'salto de pensamiento' como la lesión principal: los modelos truncan o evitan las cadenas de razonamiento. Además, el estudio revela que la popularidad de un tuit —una métrica no semántica— es mejor indicador del daño que su longitud. La mitigación posterior, mediante ajuste de instrucciones o preentrenamiento limpio, solo ofrece una recuperación parcial: incluso usando 4.8 veces más tokens de datos limpios, la brecha con el modelo original persiste en 17.3% para ARC-C COT, 9% para RULER y 17.4% para AdvBench.
Los autores concluyen que los atributos sociales de los datos —como la viralidad— pueden ser un factor causal de la decadencia de capacidades en los LLM durante el preentrenamiento continuo. El hallazgo, publicado en la conferencia COLM 2026, plantea la necesidad de 'chequeos rutinarios de salud cognitiva' para los modelos desplegados y en evolución, así como salvaguardas de curaduría de datos que consideren no solo la calidad semántica, sino también la dinámica de engagement de las plataformas.